Civil Services Examination · प्रश्न 42
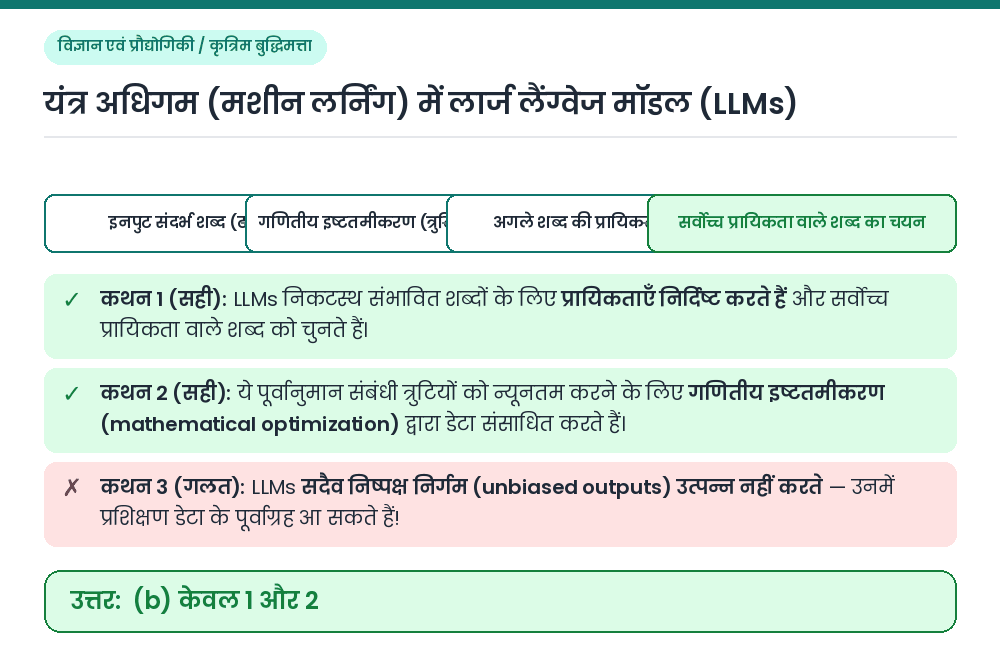
यंत्र अधिगम (मशीन लर्निंग) में प्रयुक्त लार्ज लैंग्वेज मॉडलों (LLMs) के संबंध में निम्नलिखित में से कौन-सा/कौन-से कथन सही है/हैं ? 1. LLMs निकटस्थ संभावित शब्दों के लिए प्रायिकताएँ निर्दिष्ट करते हैं और तत्पश्चात सर्वोच्च प्रायिकता वाले शब्द को चुनते हैं। 2. LLMs पूर्वानुमान संबंधी त्रुटियों को न्यूनतम करने के लिए गणितीय इष्टतमीकरण के माध्यम से डेटा का संसाधन (process) करते हैं। 3. LLMs निष्पक्ष निर्गम (unbiased outputs) उत्पन्न करते हैं। नीचे दिए गए कूट का प्रयोग कर उत्तर चुनिए :
उत्तर देखें और व्याख्याव्याख्या देखें
उत्तर: (B) केवल 1 और 2
अवधारणा: लार्ज लैंग्वेज मॉडल (LLMs) ट्रांसफ़ॉर्मर आर्किटेक्चर पर आधारित गहन तंत्रिका नेटवर्क (Deep Neural Networks) हैं जिन्हें विशाल पाठ डेटा पर प्रशिक्षित किया जाता है। कथन 1 और 2 का मूल्यांकन: ⇒ LLMs किसी वाक्य में अगले संभावित शब्दों (tokens) के लिए प्रायिकता निर्धारित करते हैं और सर्वोच्च प्रायिकता वाले शब्द का चयन कर पाठ आगे बढ़ाते हैं (कथन 1 सही); तथा प्रशिक्षण के दौरान ये पूर्वानुमान त्रुटियों (loss function) को न्यूनतम करने के लिए गणितीय इष्टतमीकरण (जैसे ग्रेडिएंट डिसेंट) का उपयोग करते हैं (कथन 2 सही)। कथन 3 का मूल्यांकन: ⇒ चूँकि LLMs मानव द्वारा लिखे गए इंटरनेट डेटा से सीखते हैं, उनमें प्रशिक्षण डेटा के सामाजिक व भाषाई पूर्वाग्रह (biases) आ जाते हैं; अतः वे सदैव निष्पक्ष निर्गम (unbiased outputs) उत्पन्न नहीं करते (कथन 3 गलत)। निष्कर्ष: केवल कथन 1 और 2 सही हैं। संबंधित तथ्य: LLMs से जुड़ी मुख्य शब्दावली: • ट्रांसफ़ॉर्मर आर्किटेक्चर (2017): यह 'सेल्फ-अटेंशन' (Self-Attention) तकनीक पर कार्य करता है जो वाक्य के शब्दों के आपसी संदर्भ को समझती है। • RLHF (मानव फीडबैक से सुदृढ़ीकरण अधिगम): मॉडल के पूर्वाग्रहों और त्रुटियों ('हैलुसिनेशन') को कम करने हेतु प्रयुक्त तकनीक। सही उत्तर: (b) केवल 1 और 2